Η νέα οικογένεια πυρήνων Arm C1 σηματοδοτεί μια σημαντική αλλαγή στο οικοσύστημα των κινητών και υπερφορητών συσκευών, αντικαθιστώντας τους γνωστούς επεξεργαστές Cortex με μια πιο σαφή εστίαση στη βιώσιμη απόδοση και αποδοτικότητα. Αυτή η γενιά έρχεται με την πλατφόρμα Lumex και έναν σαφή στόχο: να επιταχύνει την τεχνητή νοημοσύνη απευθείας στη συσκευή χωρίς να διακυβεύεται η διάρκεια ζωής της μπαταρίας ή η θερμοκρασία.
Πέρα από την αλλαγή ονόματος, η πρόταση συνδυάζει την αρχιτεκτονική Armv9.3-A , έναν ενδελεχή επανασχεδιασμό του υποσυστήματος μνήμης και μια σημαντική ενίσχυση των δυνατοτήτων υπολογιστικής μήτρας. Το αποτέλεσμα είναι εκτεταμένες βελτιώσεις στην απόδοση με χαμηλότερη κατανάλωση ενέργειας, μαζί με έναν οδικό χάρτη σχεδιασμένο για smartphones, tablet, φορητούς υπολογιστές και wearables.
Αρχιτεκτονική και νέα χαρακτηριστικά των πυρήνων Arm C1
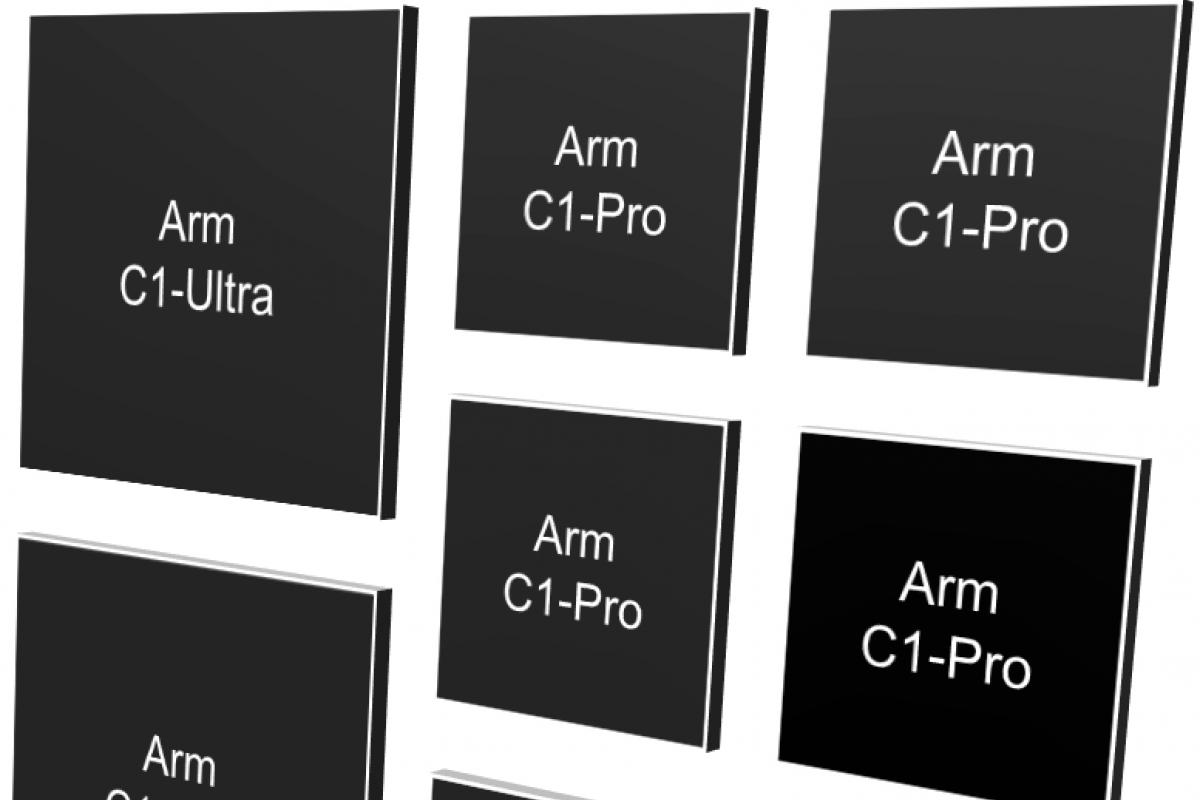
Η σειρά C1 είναι οργανωμένη σε τέσσερις παραλλαγές: C1-Ultra (μέγιστη απόδοση), C1-Premium (υψηλή απόδοση σε μικρότερο μέγεθος), C1-Pro (ισορροπημένο) και C1-Nano (μέγιστη απόδοση). Κάθε κατασκευαστής μπορεί να συνδυάσει αυτά τα μπλοκ σε ετερογενή συμπλέγματα για να δημιουργήσει SoCs προσαρμοσμένα σε διαφορετικά τμήματα της αγοράς και χρήσεις, με διαμορφώσεις έως και 14 πυρήνων.
Η Arm έχει ανανεώσει τόσο το front-end όσο και το back-end, συμπεριλαμβανομένων βελτιώσεων στην πρόβλεψη, την προσωρινή αποθήκευση και την εκτέλεση εκτός σειράς. Χάρη στη νέα διασύνδεση και μια πιο αποτελεσματική κοινόχρηστη προσωρινή μνήμη (με εντατική χρήση κελιών SLC ), η πλατφόρμα προσφέρει μέσες αυξήσεις στην απόδοση περίπου 15% στην καθημερινή χρήση, κλιμακώνοντας έως και +30% σε απαιτητικά φόρτα εργασίας και φτάνοντας σε κορυφές έως και 45% σε περιβάλλοντα πολλαπλών πυρήνων.
Η υποστήριξη μνήμης εξελίσσεται με το LPDDR6 για μείωση της κατανάλωσης ενέργειας και της καθυστέρησης, διατηρώντας παράλληλα τη συμβατότητα με το LPDDR5X σε ταχύτητες έως και 9600 MT/s. Αυτή η βάση μνήμης, μαζί με τον επανασχεδιασμό του συμπλέγματος, ενισχύει τη διατηρήσιμη απόδοση και απόκριση υπό θερμική πίεση.
C1-Ultra: το ανώτατο όριο απόδοσης
Ως κορυφαίος πυρήνας, ο C1-Ultra στοχεύει σε κορυφαία SoCs και απαιτητικές εργασίες όπως υπολογιστική φωτογραφία, μεγάλα μοντέλα τεχνητής νοημοσύνης και παιχνίδια AAA για κινητά. Σε σύγκριση με τον Cortex-X925, η Arm ισχυρίζεται αύξηση 25% στην απόδοση ενός threaded επεξεργαστή , ένα ποσοστό που βοηθά στην κλιμάκωση της συνολικής απόδοσης όταν συνδυάζεται με περισσότερους πυρήνες στο cluster.
Το front-end βελτιώνει το εύρος ζώνης των εντολών L1 και την ακρίβεια πρόβλεψης, ενώ το back-end αυξάνει το παράθυρο εκτέλεσης εκτός σειράς κατά περίπου 25%, επιτρέποντάς του να χειρίζεται περίπου 2.000 εντολές ταυτόχρονα. Επιπλέον, το μέγεθος των δεδομένων L1 διπλασιάζεται στα 128 KB και οι ταχύτητες ανάγνωσης L1 επιταχύνονται κατά περίπου 33%.
C1-Premium: υψηλή απόδοση σε μικρότερο χώρο
Για συσκευές υψηλής ποιότητας που δεν απαιτούν απόλυτη μέγιστη απόδοση, το C1-Premium διατηρεί μια αρχιτεκτονική πολύ κοντά στην Ultra, αλλά με μείωση επιφάνειας 35% . Έχει σχεδιαστεί για να εξισορροπεί την απόδοση και το κόστος, διευκολύνοντας πιο συμπαγή σχέδια χωρίς να θυσιάζονται εντυπωσιακές προδιαγραφές.
C1-Pro: Ισορροπία και μυϊκή ενδυνάμωση πολλαπλών πυρήνων
Στην κατηγορία των πυρήνων, ο C1-Pro αντικαθιστά τον Cortex-A725 με αύξηση απόδοσης 11% με την ίδια κατανάλωση ενέργειας και βελτιώσεις στην απόδοση που φτάνουν έως και 26% λιγότερη ενέργεια με την ίδια απόδοση . Στα παιχνίδια, ο Arm αναφέρει κέρδη περίπου 16% για αυτήν την κατηγορία πυρήνων.
Οι βασικές βελτιώσεις έγκεινται σε ένα πιο ικανό front-end (βελτιωμένη στατική πρόβλεψη και πολύ μεγαλύτερο BTB ) και σε ένα back-end με μεγαλύτερο εύρος ζώνης L1D και χαμηλότερη καθυστέρηση L2 όταν η πρόβλεψη είναι σωστή. Ο προγνωστικός μηχανισμός έχει επίσης ρυθμιστεί ώστε να επιταχύνει τους χρόνους απόκρισης σε πραγματικά σενάρια.
C1-Nano: η αποδοτικότητα πάνω απ' όλα
Για ελαφριές εργασίες και εξαιρετική εξοικονόμηση κόστους, το C1-Nano αυξάνει την απόδοση κατά περίπου 26% σε σύγκριση με τον προκάτοχό του (διατηρώντας παράλληλα την περιοχή ουσιαστικά αμετάβλητη, ~+2% σε σχέση με το A520). Τα στάδια πρόβλεψης και ανάκτησης έχουν αποσυνδεθεί για να μεταφέρονται οι εντολές στο L1 πιο γρήγορα και να μειώνονται οι χρόνοι αναμονής για αποτυχημένες προβλέψεις.
Επιπλέον, η διανυσματική επεξεργασία βελτιστοποιείται , οι μονάδες απενεργοποιούνται όταν η διοχέτευση μπλοκάρει και η κίνηση μεταξύ L3 και DRAM μειώνεται (κατά περίπου 21% κατά μέσο όρο και έως 39% υπό ορισμένα φορτία), γεγονός που μειώνει την κατανάλωση ενέργειας και βελτιώνει την απόκριση.
C1-DSU: Ευέλικτα cluster και χαμηλότερη κατανάλωση
Το νέο C1-DSU ενορχηστρώνει τη σύνδεση των πυρήνων κάτω από μια κοινόχρηστη μνήμη cache L3 και γεφυρώνει το κενό με το υπόλοιπο SoC (RAM, GPU, κ.λπ.). Σε σύγκριση με προηγούμενες εκδόσεις, ο σχεδιασμός μειώνει την τυπική κατανάλωση ενέργειας του συστήματος κατά περίπου 11% και το αποτύπωμα μνήμης κατά περίπου 7%, βασιζόμενο σε λειτουργίες όπως το L3 Quick Nap για την ελαχιστοποίηση των απωλειών όταν δεν χρησιμοποιούνται.
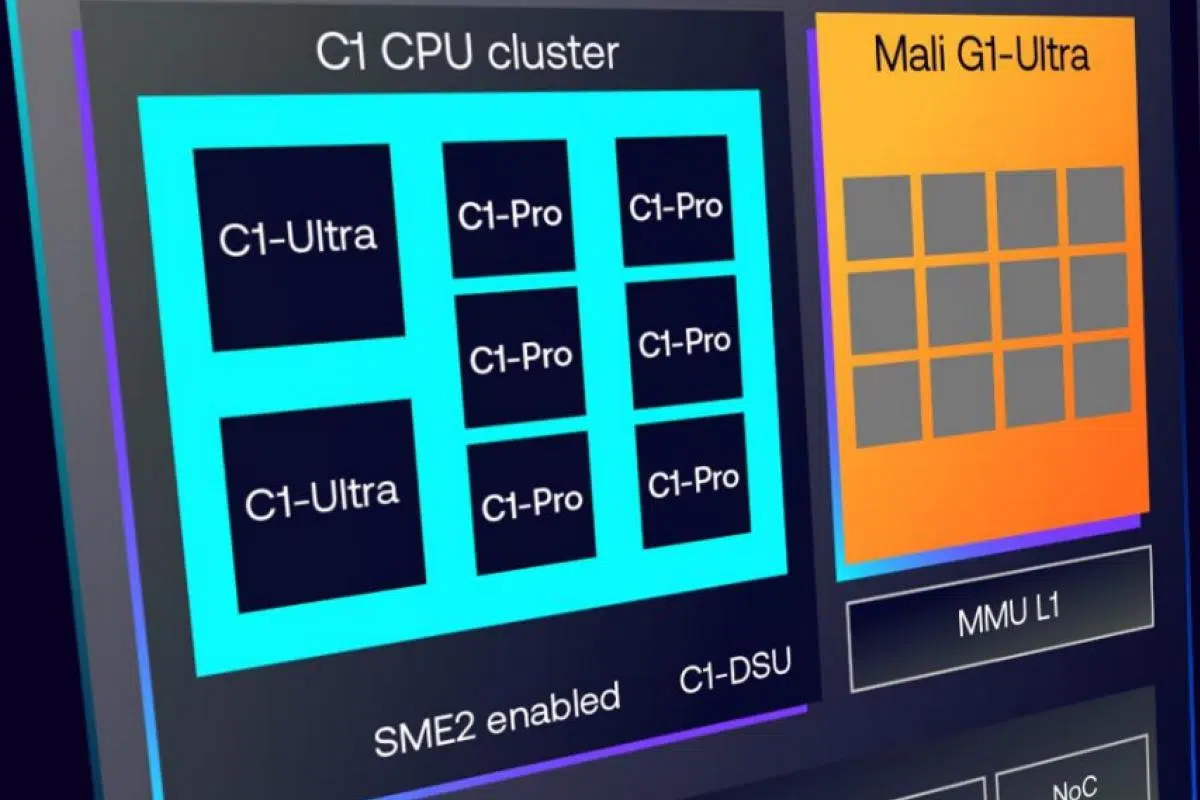
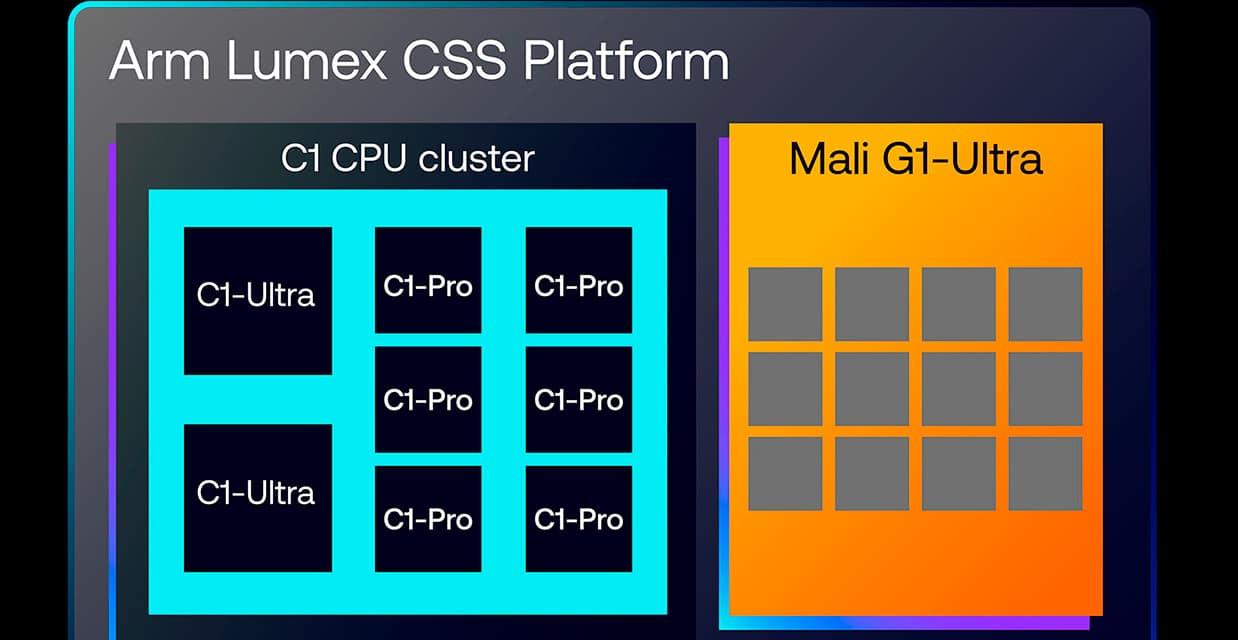
Ένα άλλο βασικό στοιχείο είναι η ενσωμάτωση των επιταχυντών SME2 ως εξωτερικά εξαρτήματα στον πυρήνα: η παρουσία τους είναι υποχρεωτική στα C1-Ultra και C1-Premium, ενώ στα C1-Pro και C1-Nano είναι προαιρετική ανάλογα με το σχεδιασμό του κατασκευαστή. Οποιοσδήποτε πυρήνας στο σύμπλεγμα μπορεί να έχει πρόσβαση σε αυτούς όταν είναι παρόντες, επιτρέποντας πολύ διαφορετικούς συνδυασμούς (για παράδειγμα, 2× C1-Ultra + 6× C1-Pro με έναν ή δύο επιταχυντές SME2 ή πιο μέτριες ρυθμίσεις που συνδυάζουν Pro και Nano).
Η πλατφόρμα Lumex περιλαμβάνει επίσης μια νέα γενιά GPU. Ενώ η έμφαση σε αυτά τα νέα δίνεται στις CPU, η Mali G1 προσφέρει βελτιώσεις περίπου 20% στην απόδοση γραφικών, διπλασιάζει την απόδοση ανίχνευσης ακτίνων και μειώνει το κόστος ενέργειας ανά καρέ κατά περίπου 9%, ενισχύοντας το πακέτο για παιχνίδια και φόρτους εργασίας τεχνητής νοημοσύνης που ευνοούν την GPU.
Το SME2 και ο ρόλος της CPU στην Τεχνητή Νοημοσύνη
Το μεγάλο άλμα στην Τεχνητή Νοημοσύνη έρχεται με το SME2 (Scalable Matrix Extension 2) , το οποίο επιταχύνει τους πολλαπλασιασμούς πινάκων, τα πολλαπλά κατηγορήματα και τους νέους τύπους δεδομένων (συμπεριλαμβανομένων των συμπαγών ακριβειών όπως 2b/4b) και συντονίζεται με το SVE2 για προηγμένη διανυσματοποίηση. Συνολικά, η Arm αναφέρει μέσες βελτιώσεις στην απόδοση κατά 3,7 φορές με μειώσεις στην κατανάλωση ενέργειας περίπου 27%.
Σε πρακτικές εφαρμογές, η εταιρεία έχει επιδείξει μειώσεις στην καθυστέρηση κατά 4,7 φορές στην αναγνώριση ομιλίας (Whisper Base), επιταχύνσεις 2,4–2,8 φορές στη μετατροπή κειμένου σε ομιλία και σημαντικές αυξήσεις στη δημιουργία διακριτικών για LLM (π.χ., Gemma 3) που πλησιάζουν το 5x . Η εκτέλεση στην CPU αποφεύγει τις μεταφορές σε άλλους επιταχυντές, μειώνοντας τους χρόνους αναμονής και βελτιώνοντας την απόκριση.
Για μικρά ή διαδραστικά φόρτα εργασίας, η CPU αναλαμβάνει και πάλι τον πρωταγωνιστικό ρόλο: με το SME2 , πολλές καθημερινές εργασίες (τοπική βελτίωση εικόνας, τμηματοποίηση, ταξινόμηση, εφέ κάμερας ή ήχου) ολοκληρώνονται ταχύτερα, χρησιμοποιώντας λιγότερη ενέργεια και χωρίς κίνηση δικτύου. Όταν αυξάνεται η ζήτηση, η GPU ή μια εξωτερική NPU μπορεί να συνεχίσει να αναλαμβάνει, αλλά η CPU δεν αποτελεί πλέον σημείο συμφόρησης.
Περιλαμβάνεται επίσης υποστήριξη λογισμικού: υπάρχει ενσωμάτωση με Linux και Android 16 , βελτιστοποιημένες αλυσίδες εργαλείων και βιβλιοθήκες (KleidiAI) και συμβατότητα με μηχανές όπως η Unity και η Unreal Engine . Αυτό θα διευκολύνει τις εφαρμογές και τα παιχνίδια να υιοθετήσουν γρήγορα αυτές τις βελτιώσεις καθώς θα είναι διαθέσιμα τα πρώτα εμπορικά SoC.
Η πλατφόρμα Lumex CSS συνδυάζει όλα τα κομμάτια - την CPU C1, την GPU Mali G1, τη διασύνδεση και τη μνήμη - με σχέδια 3nm έτοιμα για παραγωγή , τηλεμετρία υλικού και συμβατότητα συστήματος Arm με LPDDR6. Αυτό επιτρέπει στους συνεργάτες να επιταχύνουν τα έργα τους για κινητά και φορητούς υπολογιστές με κλιμακούμενα clusters έως και 14 πυρήνες και επιλογές τεχνητής νοημοσύνης στη συσκευή.
Ο Arm C1 συνδυάζει διατηρήσιμη απόδοση , αποδοτικότητα και πραγματική ώθηση στην Τεχνητή Νοημοσύνη (AI) στην CPU χάρη στο SME2. Προσφέρει την ευελιξία του C1-DSU να προσαρμόζει τα clusters σε κάθε γκάμα προϊόντων και αποτελεί μια σταθερή βάση για την επόμενη γενιά κινητών και φορητών SoCs που επιδιώκουν να εξισορροπήσουν την ισχύ, την αυτονομία και τις δυνατότητες AI χωρίς να εξαρτώνται πάντα από το cloud.